Features Transformation and Engineering
Solutions
- Features Transformation and Engineering
- Feature Transformation
- Feature Encoding
- Handling Missing Data
- Feature Selection
Feature Transformation
| Transformation | Use Case | Equation / Calculation Method |
|---|---|---|
| Log Transformation | Stabilizing variance, normalizing data, useful for data with exponential changes (e.g., economic data). | y = log(x) |
| Square Root Transformation | Stabilizing variance, normalizing data, suitable for data sets with non-negative values (counts, areas). | y = √x |
| Box-Cox Transformation | Generalized form for stabilizing variance, making data more normal-like, applicable in various scenarios. | y(λ) = (x^λ -1)/λ, for x > 0 and λ ≠ 0 |
| Z-Score / Standard Score / Standardization | Standardizing data to have mean of 0 and standard deviation of 1, used in outlier detection and normalization. | z = (x-µ)/σ |
| Min-Max Scaling | Scaling data to a fixed range (0-1), useful in scale-sensitive algorithms (neural networks, k-NN). | Xscaled = (X - Xmin) / (Xmax - Xmin) |
| Normalization (L1, L2 norms) | Scaling individual samples, essential for algorithms needing comparable scales (support vector machines). | |
| Difference Transformation | Making time-series data stationary by subtracting previous observation from the current one. | Δxt = xt - xt-1 |
| Categorical Encoding | Converting categorical data into a numeric format for use in mathematical models (One-Hot, Label Encoding). | One-Hot: Binary vectors, Label: Integer encoding |
| Binning/Discretization | Transforming continuous variables into discrete bins, simplifying complex relationships in data. | Interval: Equal-Width Quantile: Equal Frequency Count Tree-Based: Decision Tree |
Feature Encoding
| Type | Data Type | Details |
|---|---|---|
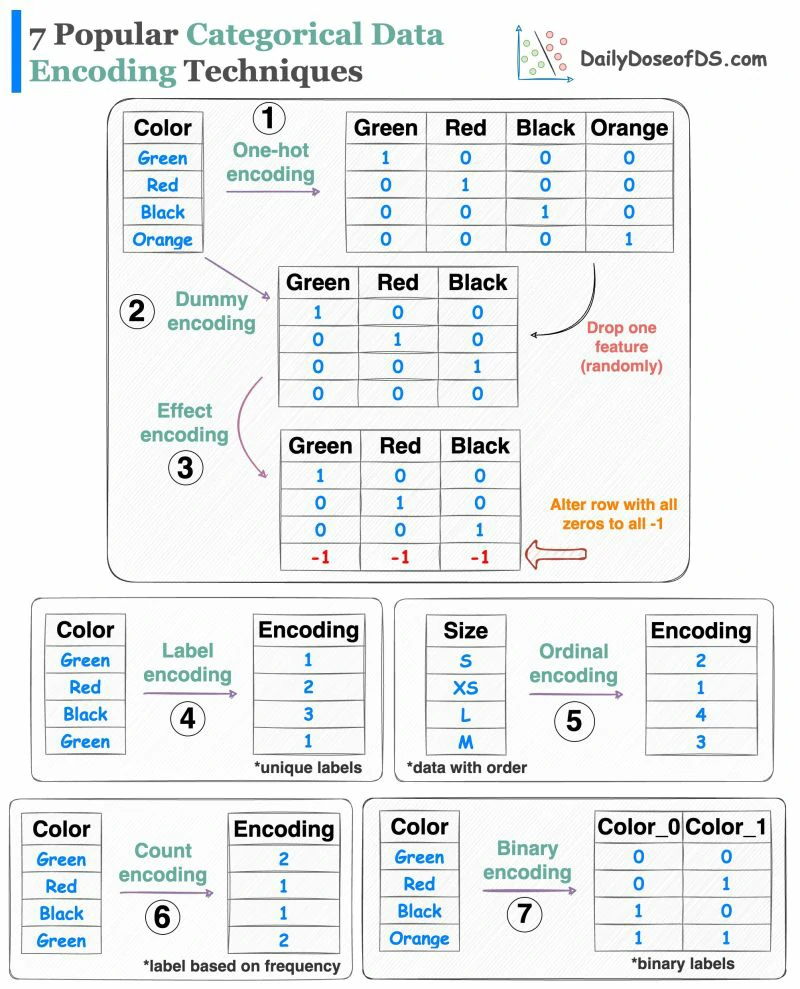
| Label Encoding | Ordinal data | Unique labels with Equal interval |
| Ordinal Encoding | Ordinal data | Same as label encoding with ordered data |
| Target-guided Encoding | Ordinal data | Equal interval |
| Polynomial Encoding | Ordinal data | Non-Equal interval |
| Helmert Encoding | Ordinal data | Non-Equal interval |
| Sum/ Count Encoding | Ordinal data | Contains count or sum for each category, Non-Equal interval |
| Backward Different Encoding | Ordinal data | Non-Equal interval |
| One-hot Encoding | Nominal data | Convert all categories into each column with 0 1, < 15 Cardinality, not suitable for decision-tree based algorithm |
| Dummy Encoding | Nominal data | Same as One-hot encoding with drop one feature (randomly) |
| Effect Encoding | Nominal data | Same as Dummy encoding with alter row with zeros to all -1 |
| Mean Encoding | Nominal data | |
| Binary Encoding | Ordinal / Nominal data | converts data into more several columns in binary labels, each colums contain 0 and 1 to label each category in binary, Some info loss acceptable for lower dimesionality |
| BaseN Encoding | Ordinal / Nominal data | |
| Feature Hashing Encoding | Ordinal / Nominal data | Some info loss acceptable for lower dimesionality |
| Frequency Encoding | Ordinal / Nominal data | |
| LeaveOneOut Encoding | Ordinal / Nominal data | info loss is not acceptable, the encoder can handle overfitting / response leakage |
| Target Encoding | Ordinal / Nominal data | info loss is not acceptable, the encoder can’t handle overfitting / response leakage |
| Weights of Evidence Encoding | Ordinal / Nominal data | info loss is not acceptable, the encoder can’t handle overfitting / response leakage |
| James-Stein Encoding | Ordinal / Nominal data | info loss is not acceptable, the encoder can’t handle overfitting / response leakage |
| M-Estimator Encoding | Ordinal / Nominal data | info loss is not acceptable, the encoder can’t handle overfitting / response leakage |
| Generalzied Linear Mixed Model Encoding | Ordinal / Nominal data | |
| CatBoost Encoding | Ordinal / Nominal data | |
| RareLabel Encoding | Ordinal / Nominal data |
Handling Missing Data
| Type | Type | Type | Details |
|---|---|---|---|
| Common data | Deletion | Deletion | Row-wise Deletion |
| Common data | Deletion | Deletion | Columns-wise Deletion |
| Time-Series data | Imputation | Mean, Median, Mode, Random Sample Imputation | Data without Trend and without seasonality |
| Time-Series data | Imputation | Linear Interpolation | Data with Trend and without seasonality |
| Time-Series data | Imputation | Seasonal adjustment + interpolation | Data with Trend and with seasonality |
| Common data | Imputation | Make NA as level | Categorical |
| Common data | Imputation | Logistic Regression | Categorical |
| Common data | Imputation | Mean, Median, Mode, Linear Regression | Numerical |
Feature Selection
| Type | Details | Methods |
|---|---|---|
| Univariate feature selection | Evaluating the statistical relationship between each feature and the target variable, Features with high scores or p-values below a certain threshold are considered significant and selected for the model. | Statistical tests such as chi-square, ANOVA, or correlation coefficients |
| Recursive Feature Elimination (RFE) | An iterative technique that starts with all features and progressively eliminates the least important ones based on model performance | RFE |